8.5. Setul de date, la îndemână#
Aici este tot calculul din acest capitol, în câteva celule. Fișierul edometre.csv are câte un rând pe încercare:
Coloană |
Ce conține |
Unitate |
|---|---|---|
|
număr de ordine (fără legătură cu lucrarea) |
– |
|
|
– |
|
adâncimea probei |
m |
|
fracțiunile granulometrice |
% |
|
limitele de plasticitate și indicele de plasticitate |
% |
|
indice de consistență, umiditate [%], indicele porilor inițial, grad de saturație |
– |
|
tasarea specifică la sfârșitul fiecărei trepte |
% |
|
tasarea specifică după descărcarea la 12,5 kPa |
% |
import numpy as np, pandas as pd, matplotlib.pyplot as plt

d = pd.read_csv("../data/edometre.csv")
print(len(d), "încercări")
d.head()
108 încercări
| id | stare | adancime_m | argila | praf | nisip | wL | wP | Ip | Ic | ... | e0 | Sr | eps_12.5 | eps_25 | eps_50 | eps_100 | eps_200 | eps_300 | eps_500 | eps_desc_12.5 | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | natural | 1.0 | 33 | 47 | 20.0 | 44 | 12 | 32 | 0.80 | ... | 0.58 | 0.83 | 0.350 | 0.85 | 1.300 | 2.25 | 3.80 | 5.35 | NaN | 4.150 |
| 1 | 2 | inundat | 1.0 | 38 | 56 | 6.0 | 52 | 14 | 38 | 0.82 | ... | 0.61 | 0.89 | 0.125 | 0.37 | 0.875 | 2.25 | 3.90 | 4.99 | NaN | 2.785 |
| 2 | 3 | natural | 2.0 | 25 | 56 | 19.0 | 43 | 15 | 28 | 1.02 | ... | 0.65 | 0.58 | 0.600 | 1.15 | 1.900 | 2.50 | 3.65 | 4.55 | NaN | NaN |
| 3 | 4 | inundat | 1.0 | 34 | 56 | 10.0 | 55 | 18 | 37 | 0.80 | ... | 0.76 | 0.86 | 0.050 | 0.60 | 1.500 | 2.90 | 5.60 | 7.90 | NaN | 5.000 |
| 4 | 5 | natural | 5.0 | 29 | 64 | 7.0 | 38 | 16 | 22 | 0.82 | ... | 0.73 | 0.71 | 0.500 | 0.85 | 1.300 | 2.00 | 2.75 | 3.70 | NaN | NaN |
5 rows × 21 columns
def e_la(s):
    """Indicele porilor [–] la sfârșitul treptei s [kPa]."""
    return d.e0 - d[f"eps_{s:g}"]/100*(1 + d.e0)

d["Cc_1_2"] = (e_la(100) - e_la(200))/np.log10(200/100)          # panta pe 100–200 kPa [–]
d["Cc_2_3"] = (e_la(200) - e_la(300))/np.log10(300/200)          # panta pe 200–300 kPa [–]
e_desc      = d.e0 - d["eps_desc_12.5"]/100*(1 + d.e0)
d["Cs"]     = (e_desc - e_la(300))/np.log10(300/12.5)            # din descărcare [–]
d["M_2_3"]  = 100/((d.eps_300 - d.eps_200)/100)                  # modul edometric [kPa]
d["lam_s"]  = d.Cc_2_3/(2.3*(1 + d.e0))                          # λ* aparent [–]
d["kap_s"]  = 2*d.Cs/(2.3*(1 + d.e0))                            # κ* [–]
d["E100"]   = 100/(((d.eps_200 - d.eps_50)/100)/np.log(4))       # rigiditate tangentă la ~100 kPa [kPa]

d[["Cc_1_2", "Cc_2_3", "Cs", "M_2_3", "lam_s", "kap_s", "E100"]].describe().loc[["count", "25%", "50%", "75%"]].round(4)
| Cc_1_2 | Cc_2_3 | Cs | M_2_3 | lam_s | kap_s | E100 | |
|---|---|---|---|---|---|---|---|
| count | 108.0000 | 108.0000 | 81.0000 | 108.0000 | 108.0000 | 81.0000 | 108.0000 |
| 25% | 0.0710 | 0.0985 | 0.0167 | 4849.0128 | 0.0271 | 0.0088 | 3798.0667 |
| 50% | 0.0911 | 0.1274 | 0.0225 | 7019.7044 | 0.0352 | 0.0126 | 4929.1440 |
| 75% | 0.1295 | 0.1980 | 0.0274 | 9111.7598 | 0.0509 | 0.0148 | 6027.3668 |
reguli = {
    "Cc = 0,009 (wL − 10)":      (d.Cc_2_3, 0.009*(d.wL - 10)),
    "Cc = Ip / 74":              (d.Cc_2_3, d.Ip/74),
    "Cc = 0,40 (e0 − 0,25)":     (d.Cc_2_3, 0.40*(d.e0 - 0.25)),
    "Cs = Ip / 370":             (d.Cs,     d.Ip/370),
    "λ* = Ip / 500":             (d.lam_s,  d.Ip/500),
    "Eoed = 37 000 / Ip [kPa]":  (d.E100,   37000/d.Ip),
}
rez = []
for nume, (mas, prez) in reguli.items():
    ok = mas.notna() & (mas > 0) & (prez > 0)
    r = (mas/prez)[ok]
    rez.append((nume, ok.sum(), round(r.median(), 2), round(r.quantile(.25), 2), round(r.quantile(.75), 2),
                round(np.corrcoef(mas[ok], prez[ok])[0, 1], 2)))
pd.DataFrame(rez, columns=["regula", "n", "măsurat/prezis (mediană)", "cuartila 25 %", "cuartila 75 %", "corelația r"])
| regula | n | măsurat/prezis (mediană) | cuartila 25 % | cuartila 75 % | corelația r | |
|---|---|---|---|---|---|---|
| 0 | Cc = 0,009 (wL − 10) | 108 | 0.40 | 0.30 | 0.72 | 0.27 |
| 1 | Cc = Ip / 74 | 108 | 0.32 | 0.23 | 0.60 | 0.17 |
| 2 | Cc = 0,40 (e0 − 0,25) | 108 | 0.93 | 0.64 | 1.16 | 0.76 |
| 3 | Cs = Ip / 370 | 81 | 0.25 | 0.21 | 0.31 | 0.47 |
| 4 | λ* = Ip / 500 | 108 | 0.55 | 0.41 | 0.91 | 0.05 |
| 5 | Eoed = 37 000 / Ip [kPa] | 108 | 4.22 | 2.62 | 5.17 | -0.12 |
8.5.1. Încercarea ta, lângă celelalte#
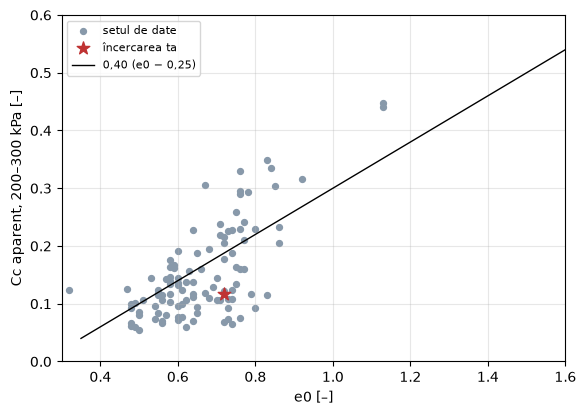
Completează mai jos datele unei încercări proprii și vezi unde cade față de set.
# --- încercarea ta (valorile de aici sunt un exemplu) ---
e0_meu, wL_meu, Ip_meu = 0.72, 48, 31                       # [–], [%], [%]
trepte  = [12.5, 25, 50, 100, 200, 300]                      # [kPa]
eps_meu = [0.20, 0.55, 1.10, 2.00, 3.40, 4.60]               # tasări specifice [%]

e_meu  = [e0_meu - x/100*(1 + e0_meu) for x in eps_meu]
Cc_meu = (e_meu[4] - e_meu[5])/np.log10(1.5)
print(f"Cc aparent (200–300 kPa) = {Cc_meu:.3f} [–];  M2-3 = {100/((eps_meu[5]-eps_meu[4])/100):.0f} kPa")
print(f"reguli:  0,009(wL−10) = {0.009*(wL_meu-10):.3f};  Ip/74 = {Ip_meu/74:.3f};  0,40(e0−0,25) = {0.40*(e0_meu-0.25):.3f}")

fig, ax = plt.subplots(figsize=(6.5, 4.5))
ax.scatter(d.e0, d.Cc_2_3, s=18, c="#8899aa", label="setul de date")
ax.scatter([e0_meu], [Cc_meu], s=90, c="#bf3333", marker="*", label="încercarea ta", zorder=3)
x = np.linspace(0.35, 1.6, 20); ax.plot(x, 0.40*(x - 0.25), "k-", lw=1, label="0,40 (e0 − 0,25)")
ax.set_xlabel("e0 [–]"); ax.set_ylabel("Cc aparent, 200–300 kPa [–]"); ax.set_xlim(0.3, 1.6); ax.set_ylim(0, 0.6)
ax.grid(alpha=.3); ax.legend(fontsize=8); plt.show()
Cc aparent (200–300 kPa) = 0.117 [–];  M2-3 = 8333 kPa
reguli:  0,009(wL−10) = 0.342;  Ip/74 = 0.419;  0,40(e0−0,25) = 0.188
De încercat
Refă tabelul regulilor numai pentru probele inundate (
d[d.stare == "inundat"]). Se schimbă concluziile?Desenează raportul
Cc_2_3/(Ip/74)în funcție deIc. Probele mai moi sunt mai aproape de regulă?Caută cele trei încercări duse la 500 kPa (
d[d.eps_500.notna()]) și calculează panta pe 300–500 kPa. Continuă să crească?Potrivește o dreaptă proprie
Cc = a (e0 − b)pe set (np.polyfit). Cât de departe este de cele din literatură?